안녕하세용,, 끄적이잉입니당,,ㅎㅎ
오늘은 뜨거운 감자인 AI에서 자주 사용되는 용어를 하나 알아보려고 하는데용,,
최근에 최적화와 효율성 그 사이 어딘가에서
비용을 고려하는 시간이 다가옴에 따라
토큰을 어떻게 최적화해서 쓰는지?
조금이라도 낮은 비용으로 높은 효율을 낼 수 있는지?
의문이 있는 것 같습니당,,
이때 자주 사용되는 용어인,,
토큰맥싱(Tokenmaxing)에 대해 한 번 알아보도록 하겠습니당,,ㅎㅎ
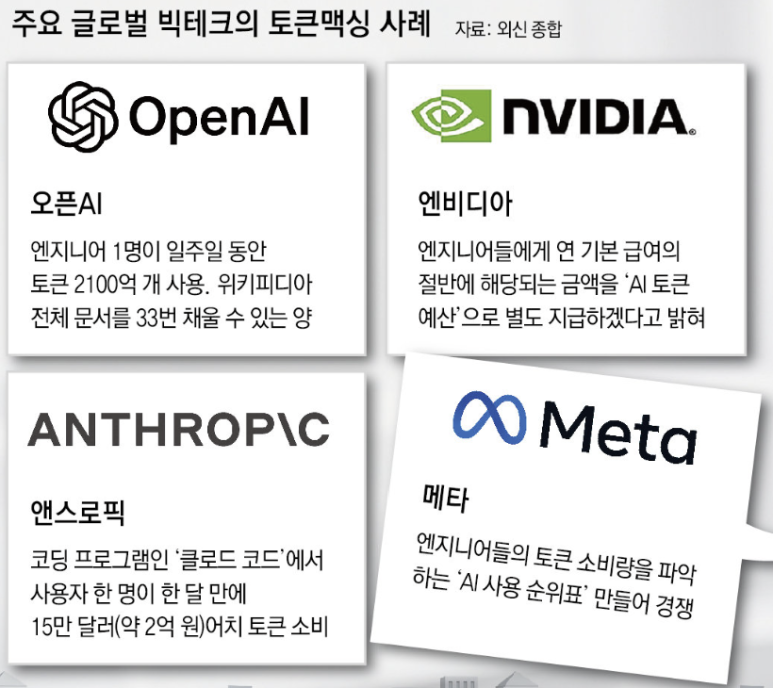
먼저 토큰맥싱(tokenmaxing 또는 tokenmaxxing)은 생성형 AI 분야에서 사용하는 AI 토큰(Token) 사용량을 극대화하여 능력을 과시하거나 생산성의 척도로 삼는 현상을 뜻하는 기술/조직 문화 용어입니다
토큰맥싱이라는 단어의 유래는,,
AI 모델의 최소 처리 단위인 Token과
최대화하다라는 뜻의 신조어 Maxing or Maxxing이 합쳐진 단어입니다
Maxxing 문화는 본래 피트니스나 게임, 서브컬처에서 특정 능력치를 극단으로 끌어올리는 행위를 뜻하던 인터넷 밈에서 유래했다고 하는데요
기술적으로는 주어진 컨텍스트 윈도우(Context Window)와 호출 빈도를 극한으로 쥐어짜내는 행위를 의미하며 단순히 질문을 여러번 하는 것부터, 에이전트 시스템이 무한 루프를 돌게 하여 API 호출을 극단적으로 폭증시키는 행위를 포함하게 됩니다
조금 더 자세히 알아보자면,,
현재 AI 시장이 발전함에 따라 여러 하이퍼스케일러 기업들이 여러 AI Tool들을 개발해서 내놓았는데요
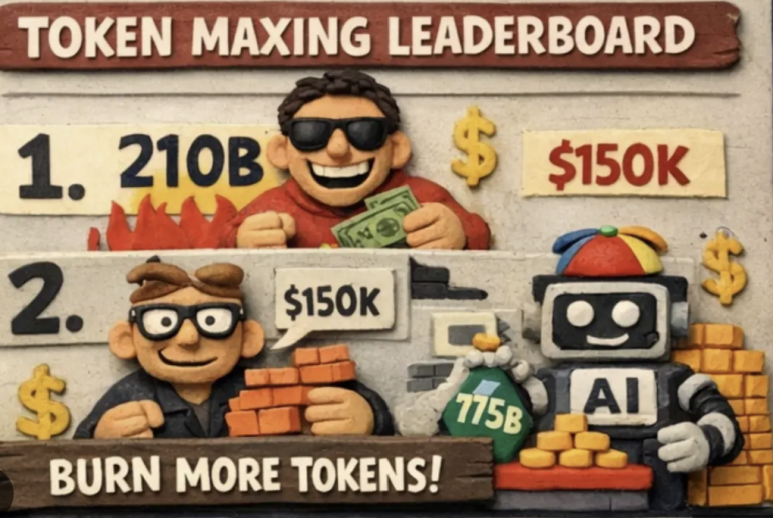
이때 개발자나 직원들이 AI Tool인 Chat GPT나 Claude, GitHub, Copilot, Gemini 등등을 얼마나 많이, 깊게 사용하고 있는지를 보여주기 위해 의도적으로 토큰 사용량을 늘리는 행위나 문화를 말합니다
빅테크 및 여러 기업들이 AI 도입 초기 직원들이 AI를 적극적으로 쓰게 만들자는 목표로 사내 AI 토큰 사용량 순위표나 대시보드를 만들어 고과에 반영하기 시작했는데요
이에 따라 직원들이 AI를 더 효율적이고 잘 사용하기 보다는
좋은 평가를 받기 위해 일부러 질문을 길게 만들고 복잡한 에이전트 루프를 실행하며, 거대한 프롬프트를 입력해서 토큰 소모량(Burn Rate)을 억지로 부풀리는 현상이 나타난 겁니다
물론 단순히 직원들이 장난으로 문장을 길게 써서 생기는 것은 아니고, 기술적 설계나 조직적 제도 결합이 합쳐지면서 발생한 것입니다
필요한 정보만 발췌(RAG 등)해서 전달하는 것이 아니라 수백 페이지짜리 PDF, 전체 코드 베이스, 과거 대화이력을 그대로 프롬프트에 통째로 넣으면서 'AI가 알아서 찾아주겠지' 식의 게으른 프롬프팅 방식으로 컨텍스트가 과다 주입되고, 토큰을 과다하게 사용하는 것입니다
그렇다고 이게 문제가 될 거 까지야?
경제학의 굿하트의 법칙(Goodhart's Law)이 있는데요
굿하트의 법칙은 측정 지표가 목표가 되는 순간, 그 지표는 더 이상 좋은 지표가 아니라 왜곡될 수 있다고 말하는 사례 중 하나라고 볼 수 있습니다

왜냐하면 이렇게 토큰맥싱을 하게 되면 원래 목적은 AI를 생산성 향상을 위해 쓰고 보다 효율적인 Tool로서 존재해야 하지만,,
과거 개발자를 코드 줄 수로 평가하던 오류처럼 실제 생산성과 무관하게 평가되기 때문입니다
토큰을 많이 쓴다고 해서 결과물의 품질이나 실제 업무 성과가 비례해서 올라가지 않는 것이죠
가장 큰 문제는 역시 돈(FinOps문제)인데요
AI API 비용은 사용한 토큰 수에 비례하는데,,
부풀려진 프롬프트와 불필요한 호출은 기업의 클라우드, AI 비용을 기하급수적으로 늘리게 됩니다
또한, 문맥에 불필요한 정보를 너무 많이 첨부하게 되면 오히려 AI의 환각(Hallucination)이 늘어나고 정확도가 떨어지며 노이즈가 증가하여 AI 성능이 저하되는 문제도 발생합니다
|
구분
|
주요 문제점
|
기술적/경영적 영향
|
|
비용 (Cost)
|
FinOps 예산 초과
|
$100 수준의 작업에 초거대 모델(예: Claude Opus 등)의 컨텍스트를 과도하게 사용해 $1,000 이상의 API 비용 발생
|
|
성능 (Quality)
|
바늘 찾기(Needle in a Haystack) 실패
|
컨텍스트 길이가 길어질수록 모델이 중간에 위치한 핵심 지시사항을 놓치는 Lost in the Middle 현상 발생
|
|
지연시간 (Latency)
|
프롬프트 처리 시간 증가
|
입력 토큰이 커질수록 첫 번째 토큰이 출력되기까지의 시간(TTFT: Time to First Token)이 급격히 증가
|
그럼 요즘은 어떻게 사용하는 추세야?
최근 글로벌 기업들과 엔지니어링 조직들은 단순히 토큰을 많이 쓰는 토큰 맥싱 문화를 철회하고 지양하며 토큰 효율성(Token Efficiency)중심의 시스템으로 전환하고 있습니다
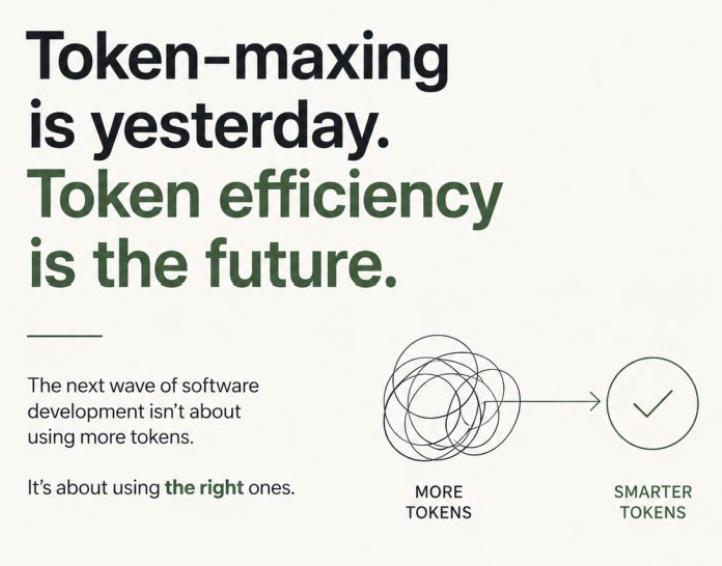
전체적인 분위기가 얼마나 썼느냐보다는 사용한 토큰 대비 어떤 가치를 창출했는가를 따지는 기조로 바뀐 것인데요
몇가지 간단하게 살펴보자면,,
모든 작업에 무겁고 파라미터가 큰 초거대 모델을 사용하지 않고, 라우팅 및 오프로딩(Model Routing)을 통해 단순 요약이나 분류, 포맷팅은 경량화 모델(SLM)을 붙이고 중요한 결론 추출에만 고성능 모델을 사용하는 토크노믹스(Tokenomics)적 설계가 정착하는 추세입니다
프롬프트 cache 및 구조화를 통해 반복적으로 사용되는 대용량 시스템 프롬프트는 Prompt Caching 기술을 적용하여 비용과 라우팅 지연 시간을 단축하기도 합니다
또한 단순 토큰 소모량을 기준으로 잡는게 아니라 작업 완수율 대비 소모 토큰(Tokens per Task Completed) 및 토큰당 ROI를 생산성 지표로 정립하며 평가 지표를 정교화했습니다
'경제' 카테고리의 다른 글
| 듀레이션(Duration)의 의미와 뜻 (0) | 2026.10.26 |
|---|---|
| 26년 10월 맥쿼리 인프라 500주 모으기 #25 (0) | 2026.10.25 |
| 26년 10월 TIGER 미국배당다우존스 ETF 3000주 모으기 #10 (1) | 2026.10.24 |
| 인플레이션(Inflation)의 의미와 뜻 그리고 사례 (0) | 2026.10.24 |
| ETHU ETF 10월 배당 확정!! (0) | 2026.10.23 |